

- V březnu 2016 porazil program AlphaGo v Soulu jednoho z nejlepších hráčů go na světě
- Z pěti partií se nejvíc vzpomíná na dva tahy, které by podle AlphaGo napadly jednoho člověka z deseti tisíc; jeden zahrál stroj, druhý člověk
- Novější AlphaGo Zero se hru naučil od nuly a po třech dnech porazil starší verzi 100:0
- Poražený mistr po nástupu AI ukončil kariéru, ostatní profesionálové ale začali hrát lépe
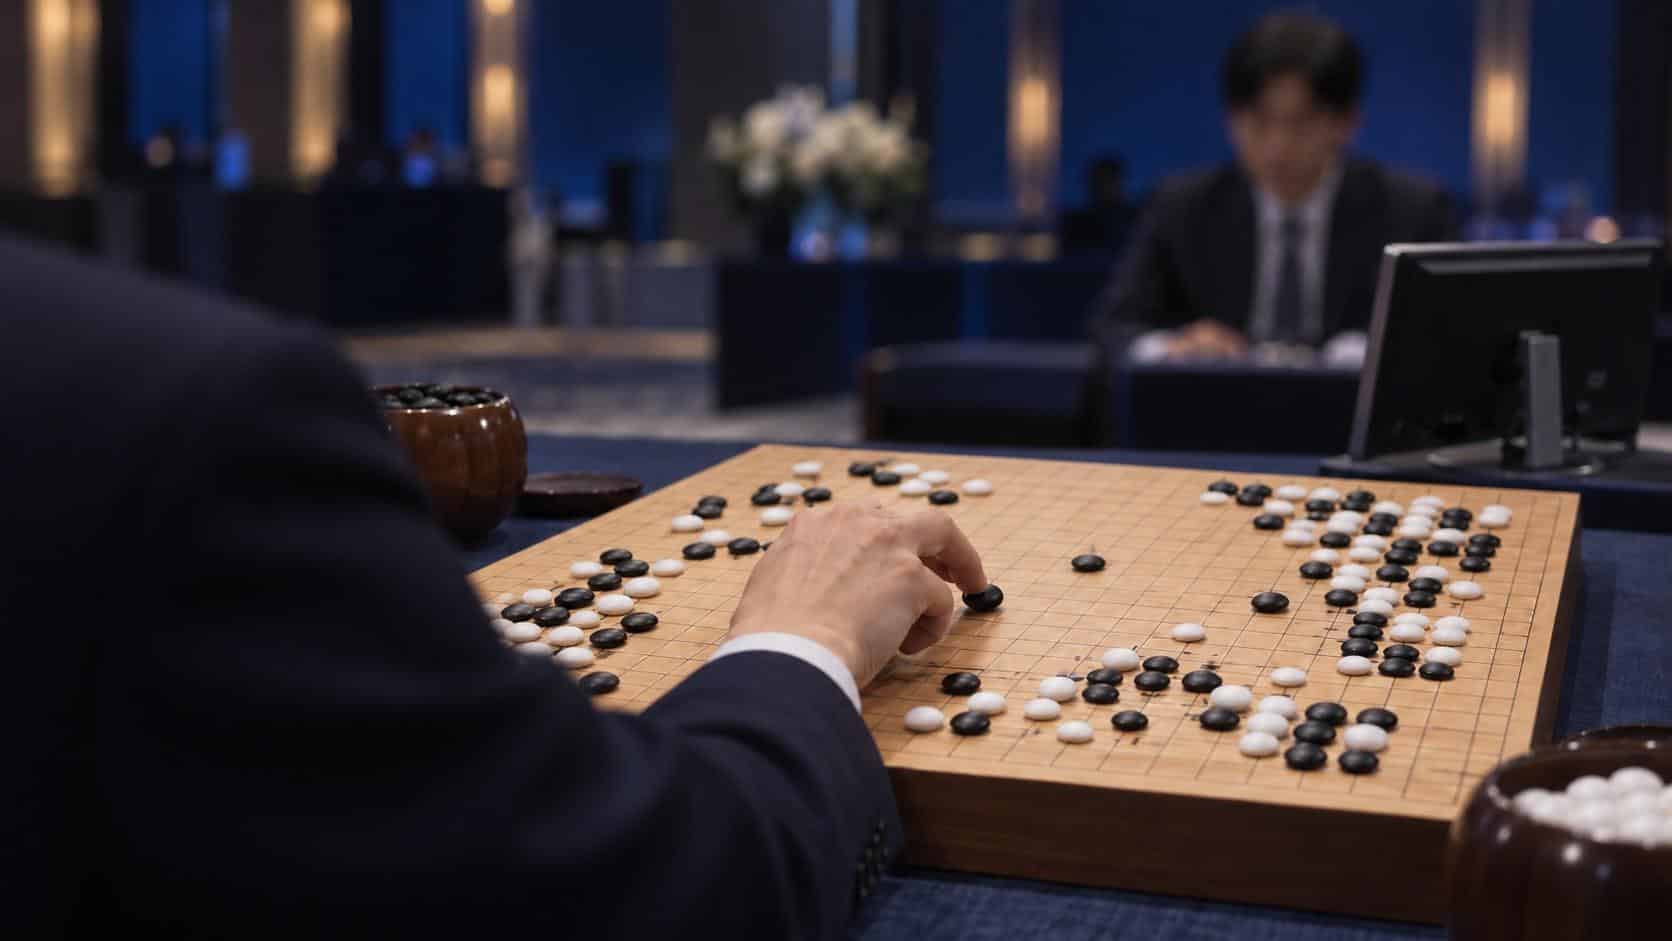
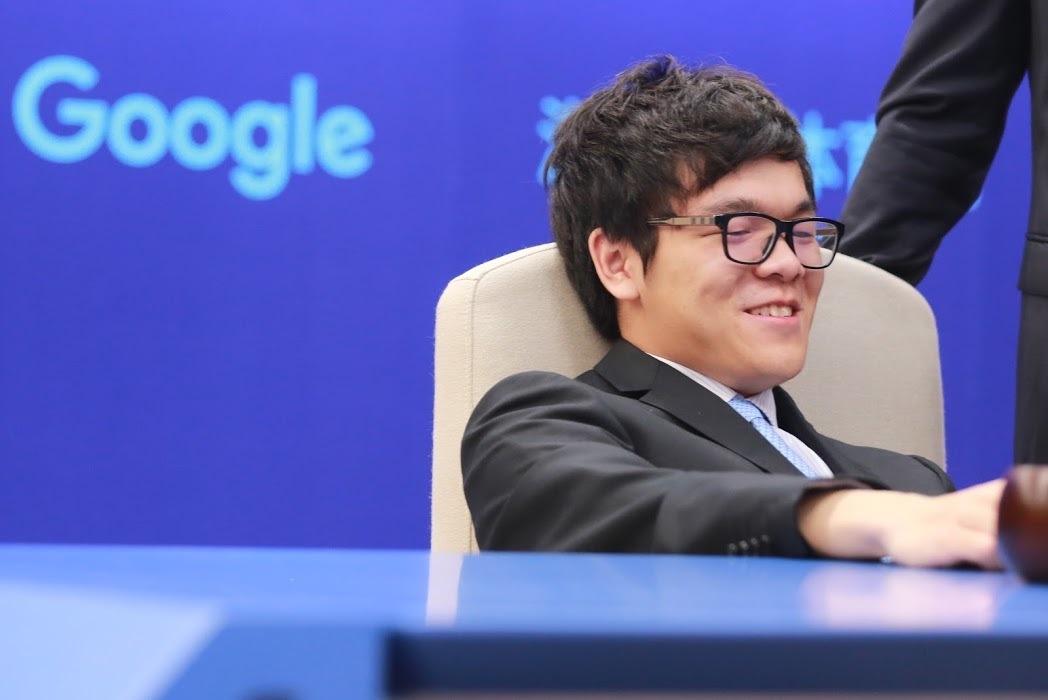
V březnu 2016 přicházel do obchodů Galaxy S7, do nástupu ChatGPT zbývalo víc než šest let a umělou inteligenci si většina lidí spojovala nanejvýš se Siri. Desítky milionů diváků přesto sledovaly přenos ze soulského hotelu Four Seasons, kde jihokorejský mistr Lee Sedol, držitel 18 mezinárodních titulů, hrál deskovou hru starou přes dva a půl tisíce let. Naproti němu seděl programátor Aja Huang, který jen pokládal kameny podle pokynů z obrazovky. Skutečným soupeřem byl program AlphaGo.
Výsledek 4:1 pro stroj dnes zná každý, kdo se o AI zajímá. Po deseti letech je ale zajímavější cesta k němu: jak se počítač naučil hru, kterou nešlo spočítat, a proč ze zápasu zůstaly v paměti hlavně dva tahy, z nichž jeden zaskočil člověka a druhý stroj.
Hra, na které si počítače vylámaly zuby
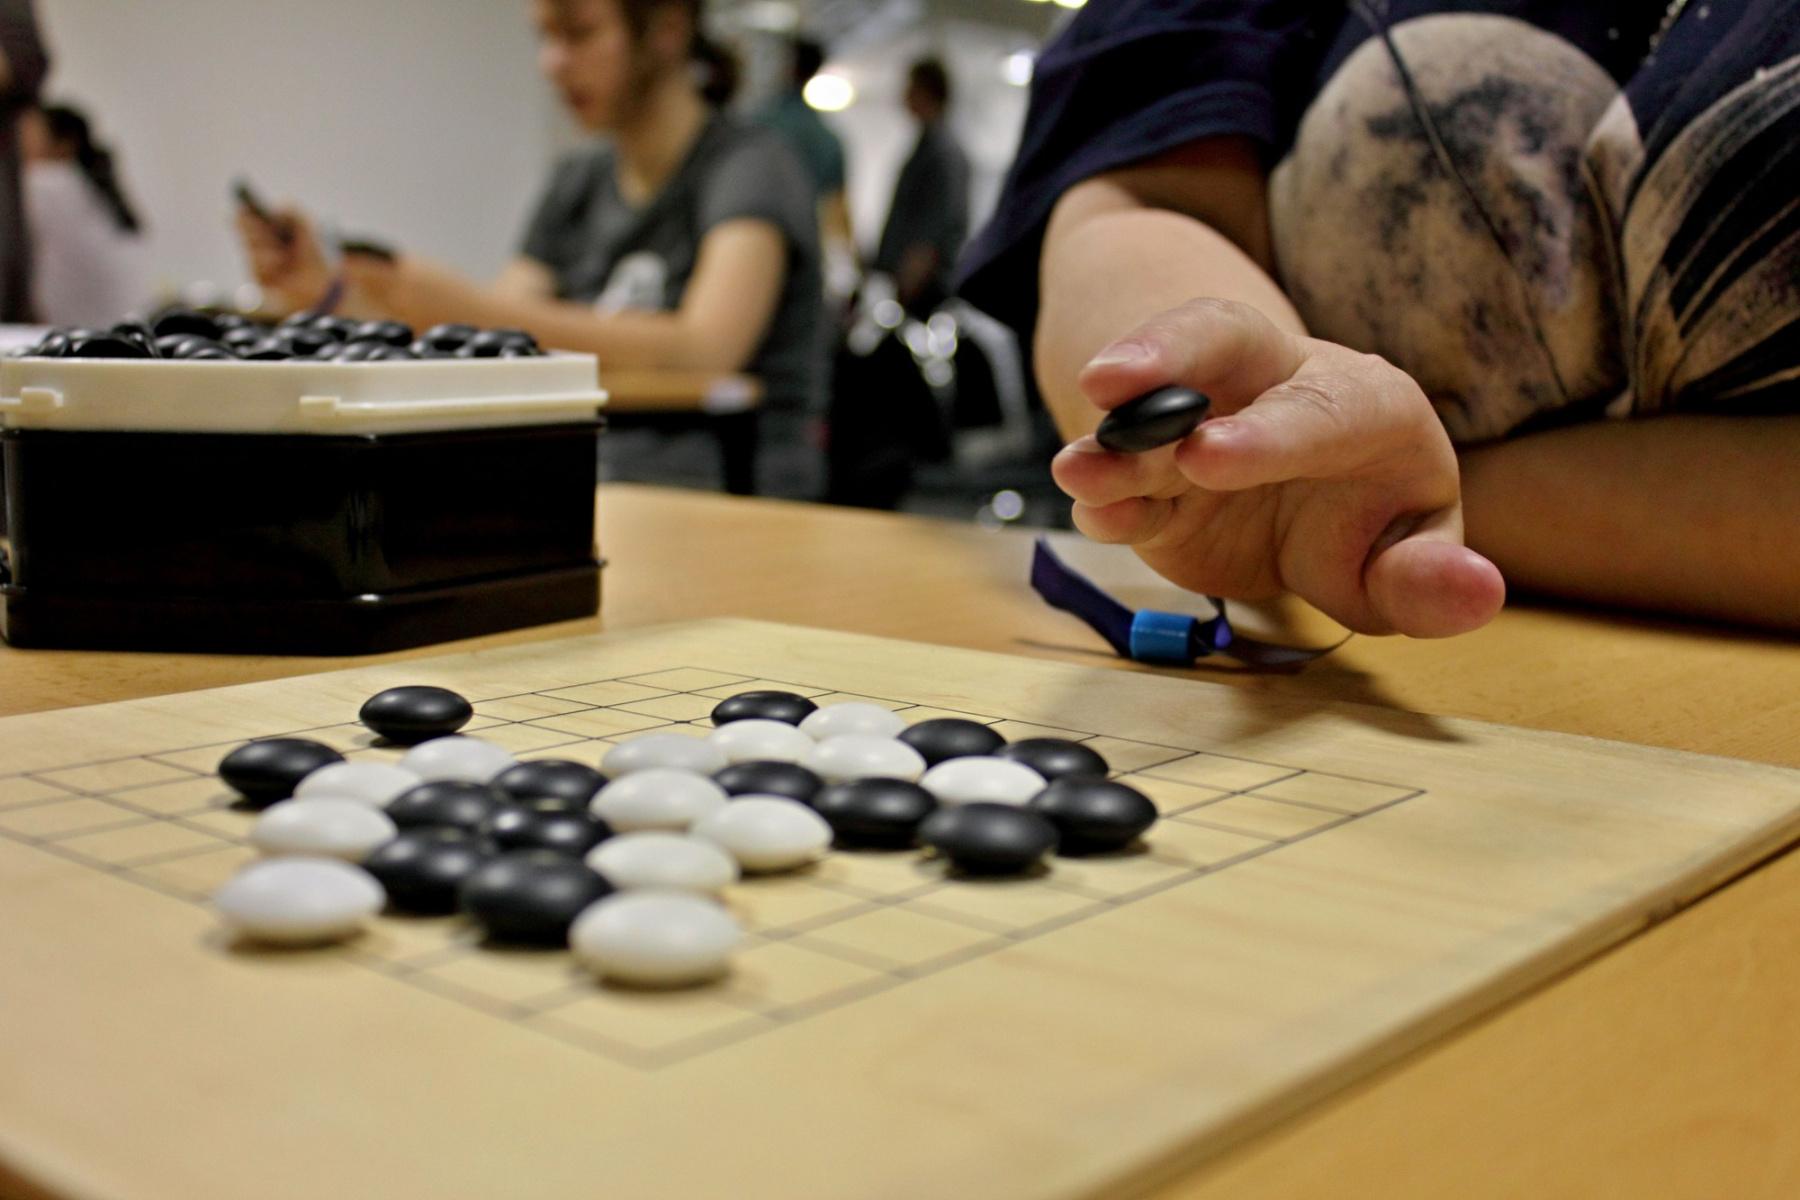
Pravidla go se dají vysvětlit za pár minut. Dva hráči střídavě pokládají kameny na průsečíky mřížky 19 × 19 a snaží se ohradit větší území než soupeř. Potíže začínají u čísel. V šachách má hráč v průměru na výběr z přibližně 35 tahů a partie jich trvá zhruba 80, v go je to kolem 250 možností a 150 tahů. Možných pozic existuje přibližně 2,1 × 10¹⁷⁰, přitom atomů v pozorovatelném vesmíru je řádově 10⁸⁰.
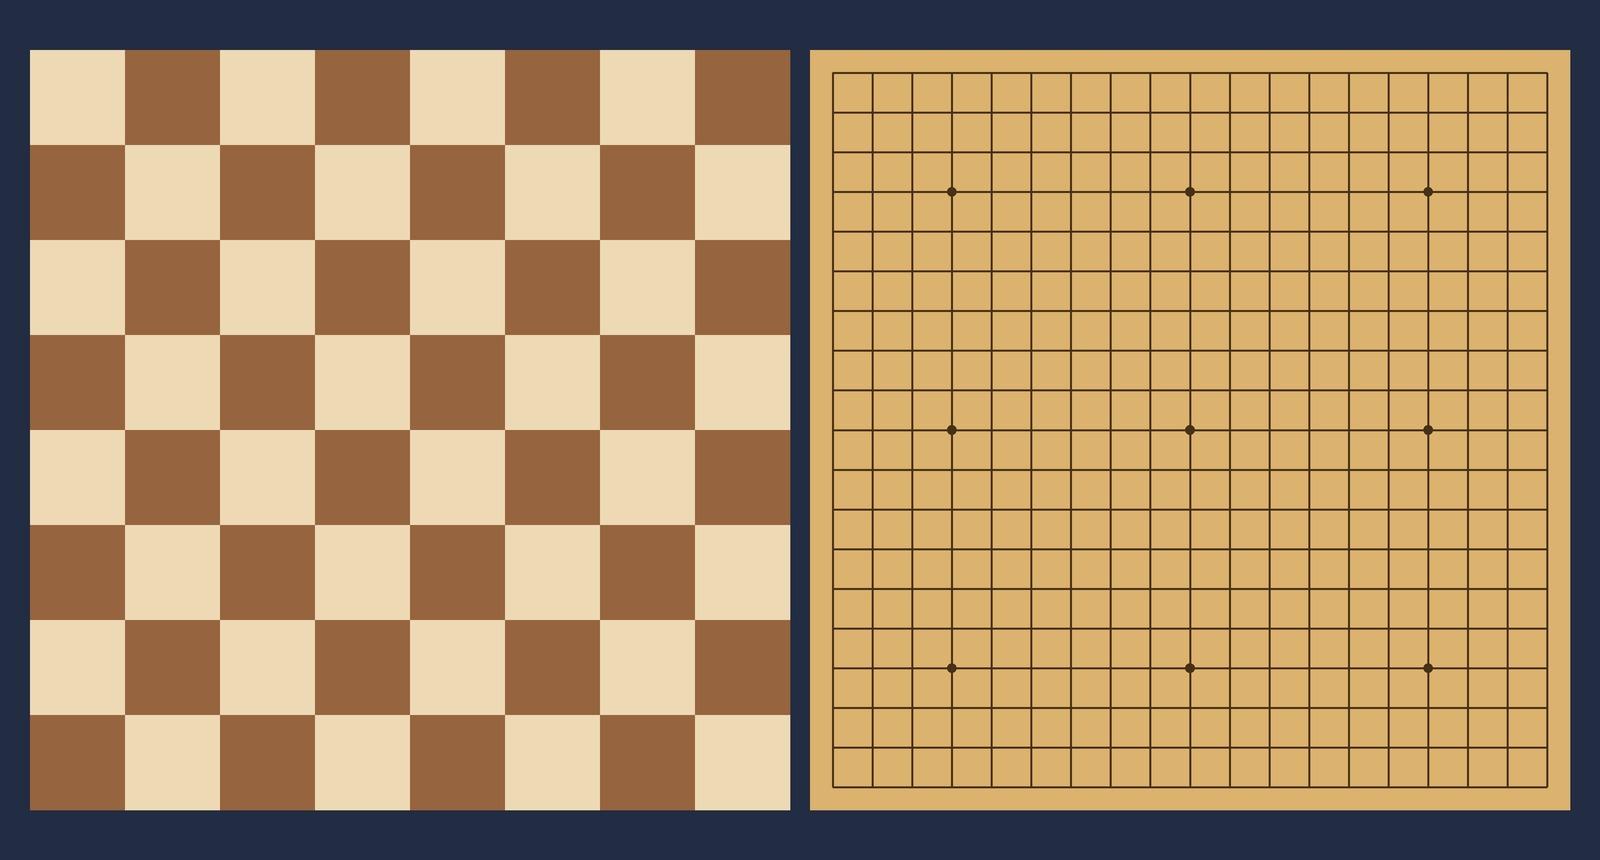
Hrubá síla, díky které Deep Blue v roce 1997 porazil Garryho Kasparova, tu narážela ještě na jeden problém. Šachovou pozici lze alespoň zhruba ohodnotit podle figur, které na desce zbyly. V go mají všechny kameny stejnou cenu a o vedení rozhoduje to, které skupiny přežijí a které se propojí. Programy tak neuměly ani dobře říct, jestli právě vyhrávají.
První velký posun přinesl v roce 2006 Rémi Coulom s metodou Monte Carlo tree search. Program při ní z dané pozice dohraje spoustu rychlých náhodných partií a sleduje, po kterých tazích nejčastěji vyhrává. Programy se tak vyrovnaly zkušeným amatérům a porazily i špičkové profesionály, ale jen když měly předem na desce čtyři kameny navíc. Na otázku, kdy počítač vyhraje bez zvýhodnění, odpověděl Coulom v roce 2014, že možná za deset let. Trvalo to asi rok a půl.
Tichá porážka v Londýně
V říjnu 2015 přijel do Londýna trojnásobný mistr Evropy Fan Hui, aby si zahrál proti programu firmy DeepMind. Spoluzaložil ji Demis Hassabis a od roku 2014 patří Googlu. Fan Hui prohrál všech pět oficiálních partií a z pěti rychlých neoficiálních vyhrál jen dvě. Program na něj působil jako zeď. Počítač tak poprvé porazil profesionála na plné desce bez zvýhodnění, svět se to ale dozvěděl až 27. ledna 2016, kdy DeepMind v časopise Nature zveřejnil, jak program funguje.
Základem byly dvě neuronové sítě, tedy modely, které se místo ručně psaných pravidel učí z příkladů. První prošla 30 milionů pozic z partií silných hráčů a naučila se odhadovat, kam by člověk táhl. Potom program hrál miliony partií sám proti sobě a na nich se učila druhá síť, která se podívá na pozici a odhadne vítěze. Přesně to programy do té doby neuměly.
Prohledávání variant metodou Monte Carlo zůstalo, přestalo však tápat. První síť mu vybrala slibné tahy a druhá spolu s rychlými dohrávkami posoudila, kam vedou. AlphaGo díky tomu vyhodnocoval řádově tisíckrát méně pozic než Deep Blue proti Kasparovovi. Podobně uvažuje zkušený hráč, který většinu tahů vůbec nezkoumá.
Lee Sedol si partie s Fan Huiem prohlédl, usoudil, že program hraje jako špičkový amatér, a předpověděl, že ho drtivě porazí. DeepMind měl ovšem pět měsíců na další trénink a poražený Fan Hui mezitím radil vývojářům AlphaGo.
Tah 37: stroj přestal napodobovat lidi
Předpověď vydržela do 9. března. První partii Lee vzdal. Skutečný otřes přišel o den později. Ke konci první hodiny druhé partie položil AlphaGo tahem číslo 37 kámen do řídce obsazené pravé části desky, na pátou řadu. Jeden z komentátorů tah označil za velmi podivný, druhý ho považoval za chybu. Lee Sedol vstal a odešel z místnosti, a když se vrátil, přemýšlel nad odpovědí skoro patnáct minut. Fan Hui, který partii v Soulu sledoval, tah také nejdřív nechápal. Asi po deseti vteřinách pochopil, že do celé pozice zapadá, a od té chvíle opakoval, jak je krásný.
Uvnitř programu se mezitím střetly dva odhady. Podle sítě vycvičené na lidských partiích by tenhle tah zahrál jeden člověk z deseti tisíc. Prohledávání variant a zkušenost z milionů partií se sebou samým ale ukázaly, že se vyplatí. AlphaGo tedy věděl, že by takový tah člověk nezahrál, a přesto ho zvolil.
Lee se vzdal a na tiskové konferenci řekl, že v žádné fázi neměl pocit, že vede. Třetí partii 12. března prohrál také, AlphaGo tím získal celý zápas i milion dolarů. Zbývaly dvě partie o čest.
Tah 78: tentokrát zaskočil člověk stroj
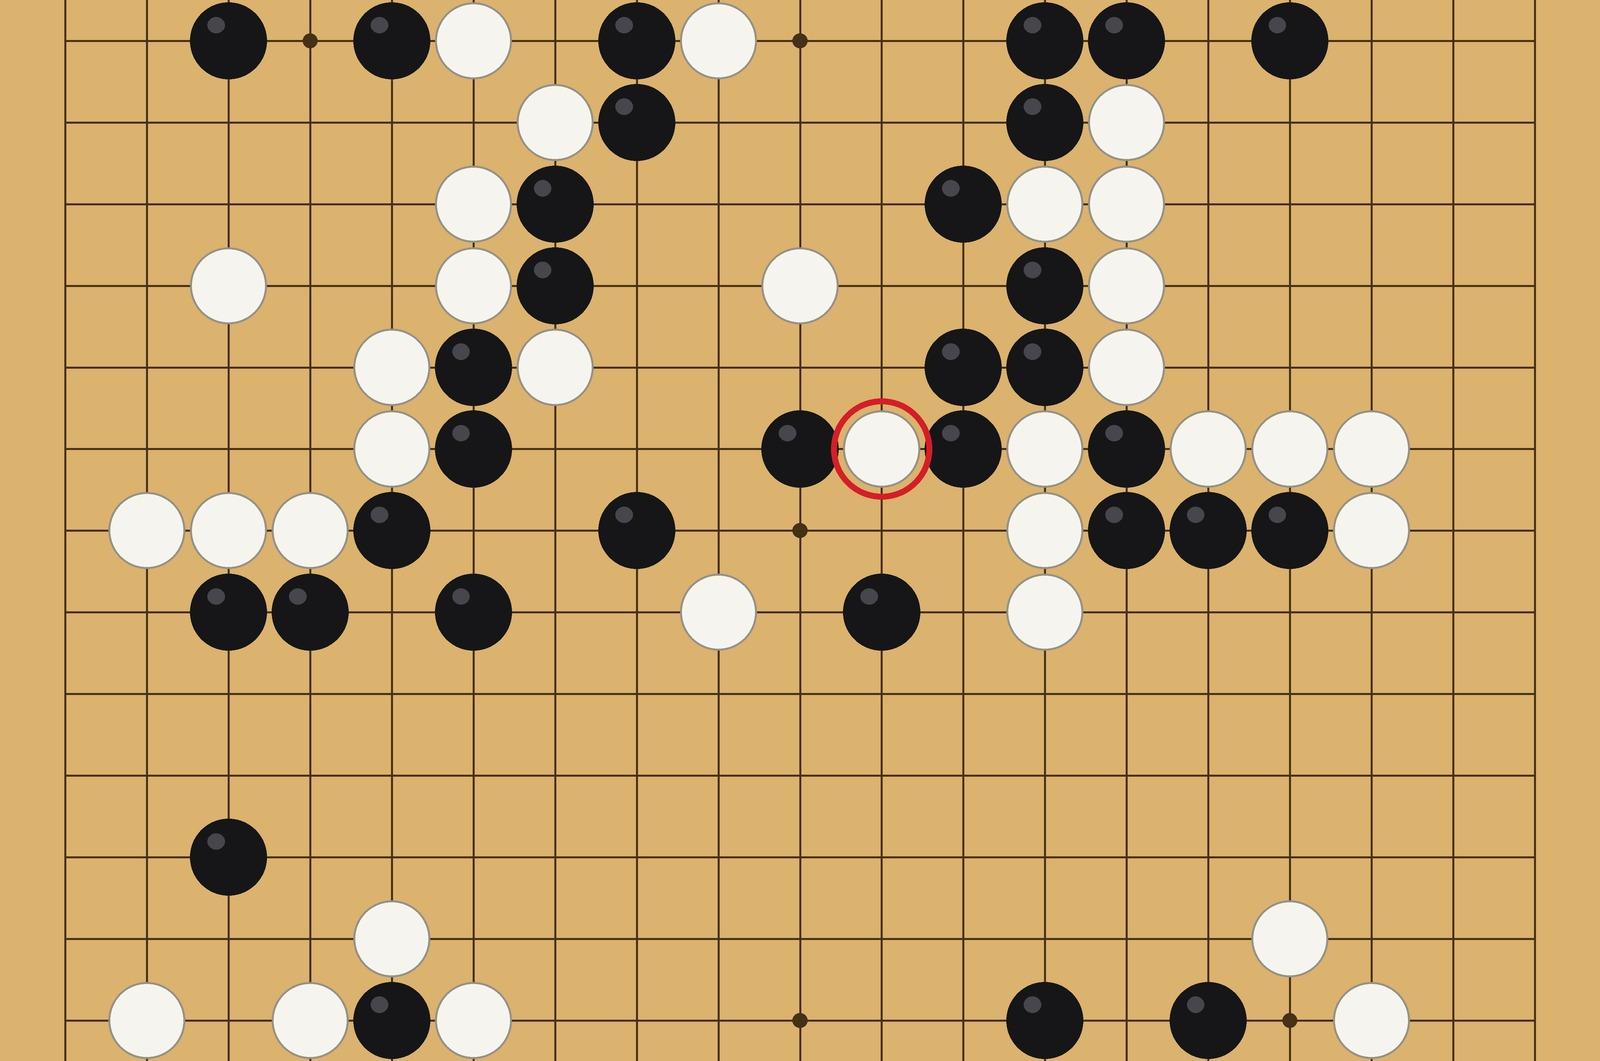
Čtvrtou partii 13. března hrál Lee bílými a v polovině to s ním nevypadalo dobře. Půl hodiny přemýšlel a pak vsunul kámen mezi soupeřovy uprostřed desky. Komentátor Michael Redmond přiznal, že ho tah zaskočil, a odhadl, že zaskočil i AlphaGo. Měl pravdu. Hned další tah programu byl vyložená chyba, za pár minut se zhroutil jeho odhad vlastních šancí a stroj začal hrát podivně. Nakonec se vzdal. Lee pak vešel na tiskovou konferenci za jásotu přítomných a řekl, že tuhle jedinou výhru by nevyměnil za nic na světě.
When I say 'thought' and 'realisation' I just mean the output of #AlphaGo value net. It was around 70% at move 79 and then dived on move 87
— Demis Hassabis (@demishassabis) March 13, 2016
Druhý den ráno Hassabis vysvětlil, co se stalo. AlphaGo počítal s tím, že na toto místo zahraje jeden člověk z deseti tisíc, stejně jako u tahu 37. Síť, která programu ušetřila většinu práce, tu ukázala i svou slabinu: varianta, kterou považuje za téměř nemyslitelnou, dostane při prohledávání jen málo pozornosti. Tah 78 byl tak výjimečný, že mu mnozí profesionálové začali říkat Boží dotek.
Pátou partii Lee vzdal. Výhra šla na charitu a korejská asociace go udělila programu čestnou nejvyšší hodnost 9. dan. Od té doby AlphaGo s člověkem veřejně neprohrál.
Tajemný Master a program bez učitele
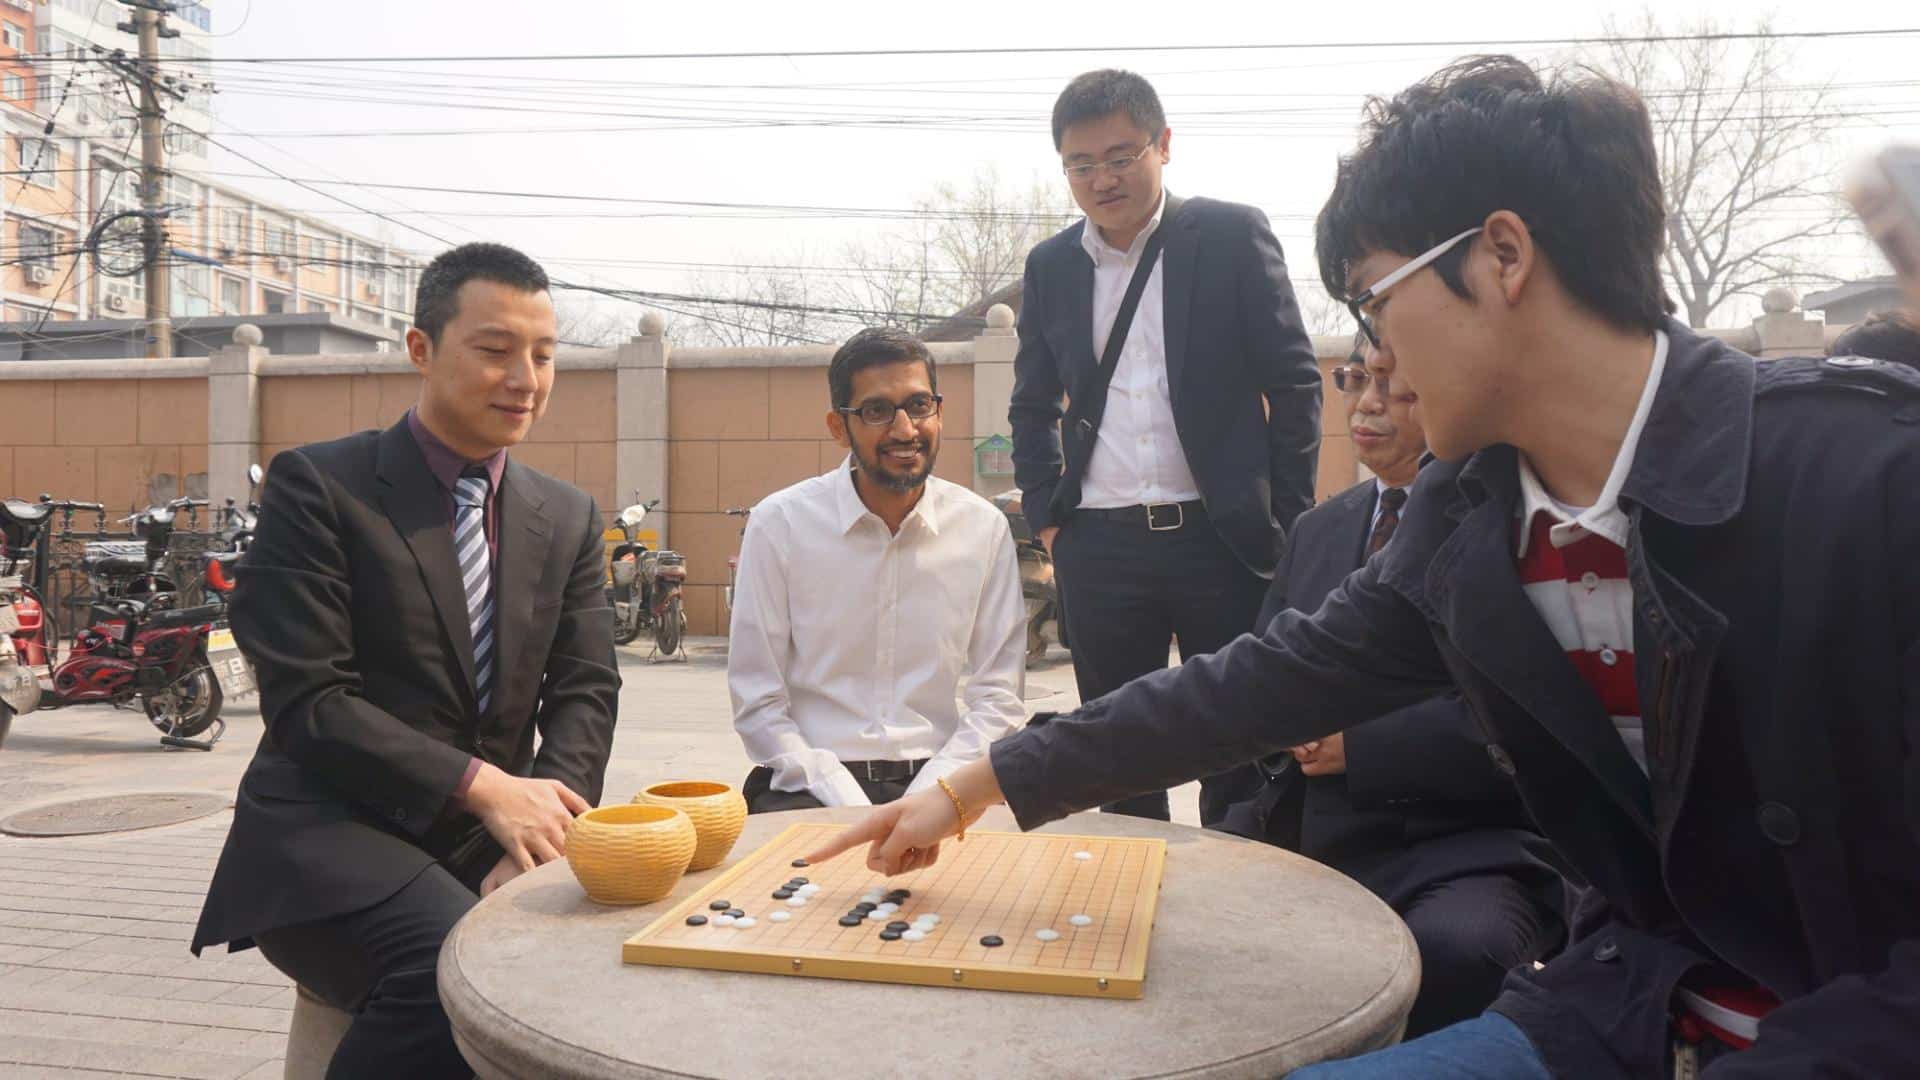
Na přelomu let 2016 a 2017 se na asijských serverech Tygem a FoxGo objevil účet Magister, později Master. Za týden nasbíral 60 výher nad profesionály bez jediné prohry a třikrát porazil i světovou jedničku Ke Jieho. Za první výhru nad Masterem byla vypsaná odměna v přepočtu asi 370 000 Kč, nikdo ji ale nezískal. Po 59. partii vyšlo v chatu najevo, že účet ovládá Aja Huang, člen týmu DeepMind, který v Soulu pokládal kameny za AlphaGo. Ke Jie tehdy poznamenal, že lidstvo tisíce let zdokonalovalo taktiku a počítače teď ukazují, že se celou dobu mýlilo. V květnu 2017 s touto verzí prohrál i osobně ve Wu-čenu 0:3. DeepMind pak AlphaGo stáhl ze soutěží.
To nejpodivnější přišlo o pět měsíců později. AlphaGo Zero dostal jen pravidla a kameny na desce, žádné lidské partie. Místo dvou sítí měl jedinou a místo náhodných dohrávek spoléhal na její odhad. Začal zcela náhodnými tahy, po třech hodinách hrál jako začátečník, který chce hlavně sebrat soupeřovy kameny, a po devatenácti už chápal, které skupiny přežijí a jak se bojuje o území. Po 47 hodinách nejčastěji útočil na rohy stejně jako profesionálové, později ale našel vlastní způsob a dal mu přednost.
Za tři dny odehrál sám se sebou 4,9 milionu partií a verzi, která porazila Lee Sedola, smetl 100:0. Po čtyřiceti dnech porazil 89:11 i Mastera, který se ještě učil z lidských partií. Dva a půl tisíce let lidských zkušeností k mistrovství potřeba nebylo.
Nepřehlédněte
Umělé inteligenci není podvádění cizí, ve hře StarCraft chtěla vyhrát nekalým způsobem
Stejný postup pak DeepMind přenesl jinam. AlphaZero se v roce 2017 sám naučil šachy, po čtyřech hodinách tréninku překonal špičkový program Stockfish a ve stovce partií proti němu vyhrál 28 a zbytek remizoval. MuZero o tři roky později zvládl i hry, jejichž pravidla předem neznal, a k hrám se Google vrací dodnes.
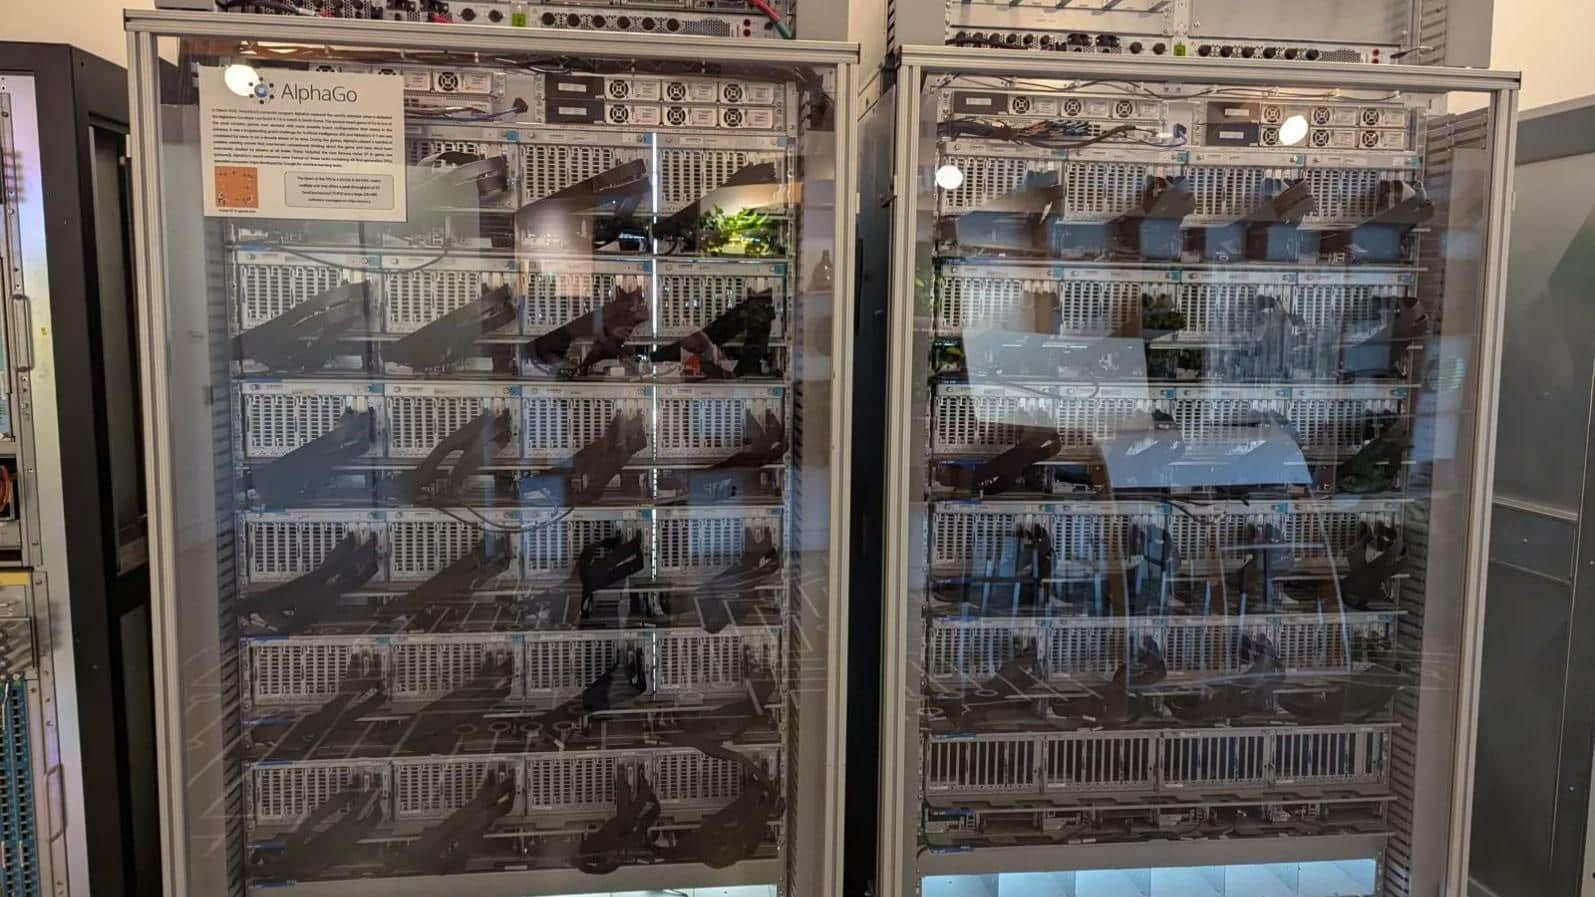
Ještě proti Fan Huiovi běžel AlphaGo na 1 202 procesorech a 176 grafických čipech. Volně dostupný KataGo, který se učí stejným způsobem, si dnes spustíte přímo v telefonu.
Go má ovšem jasná pravidla i jednoznačný výsledek, takže si stroj může cvičné partie vyrábět sám. Mimo hrací desku tenhle luxus chybí. AlphaFold ze stejné laboratoře, který předpovídá tvar proteinů a v roce 2024 vynesl Hassabisovi a Johnu Jumperovi Nobelovu cenu za chemii, se proto neučí hrou proti sobě, ale ze známých struktur. Hassabis uvádí, že část technik z AlphaGo a AlphaZero používají i nejnovější modely Gemini.
Co zbylo člověku
Lee Sedol v listopadu 2019 ukončil kariéru. Přispěl k tomu i spor s korejskou asociací, otevřeně ale Lee pojmenoval jiný důvod: „I kdybych se stal jedničkou, existuje něco, co nelze porazit.“ Ostatní profesionálové přitom začali hrát lépe. Na 5,8 milionu tahů z let 1950 až 2021 je vidět, že poté, co programy překonaly nejlepší hráče, se kvalita rozhodování výrazně zlepšila a přibylo tahů, které se v partiích dřív neobjevily.
Slabiny ale mají i tyto programy. V roce 2023 porazil amatér Kellin Pelrine program KataGo ve 14 z 15 partií. Slabinu předtím odhalil jiný počítačový program a Pelrine ji pak u desky využil sám: obklopil soupeřovu skupinu velkou smyčkou kamenů a KataGo si nebezpečí nevšiml. Stejně jako u tahu 78 stačilo zahrát to, s čím stroj nepočítal.
Letos 29. dubna se Hassabis a Lee Sedol, dnes vysokoškolský profesor, potkali v Soulu znovu. Hassabis jako nejúžasnější okamžik vybral tah 37. Lee vzpomínal, že si po zápase připadal jako žába ve studni, která zná jen svůj kousek nebe, a litoval, že se tehdy víc nerozhlížel a neučil. Lidi varoval, aby nepřenechali iniciativu v myšlení umělé inteligenci.
Celé drama si můžete připomenout v devadesátiminutovém dokumentu AlphaGo, který DeepMind zdarma zveřejnil na YouTube. Uvidíte v něm i čtvrtou partii, jedinou, kterou člověk v oficiálním zápase proti AlphaGo vyhrál. Rozhodl ji tah, který by podle programu zahrál jeden člověk z deseti tisíc.

Ondřej Dolejš
Další dnešní články